本文面向身份管理负责人和实施人员,帮助你理解通讯录同步概述的对象、数据流、适用范围和后续任务入口。本文不替代具体连接器的字段配置或目标环境验收。本文按 6.7.1 系列固定源码基线整理。由于当前仓库没有独立的 6.7.1.1 Tag,正式发布前还需核对实际构建版本,并在目标租户完成运行验证。
解决的问题#
当多个系统分别维护账号和组织时,人工重复录入容易造成状态、层级和属性不一致。通讯录同步概述用于明确数据来源、同步方向和责任边界。工作方式#
平台向目标系统写入用户和组织数据。连接、账号关联、属性映射、同步策略和结果日志共同构成一次可验证的身份数据任务。主要能力#
执行测试或同步任务,并查看历史、错误与待处理对象。
适用边界#
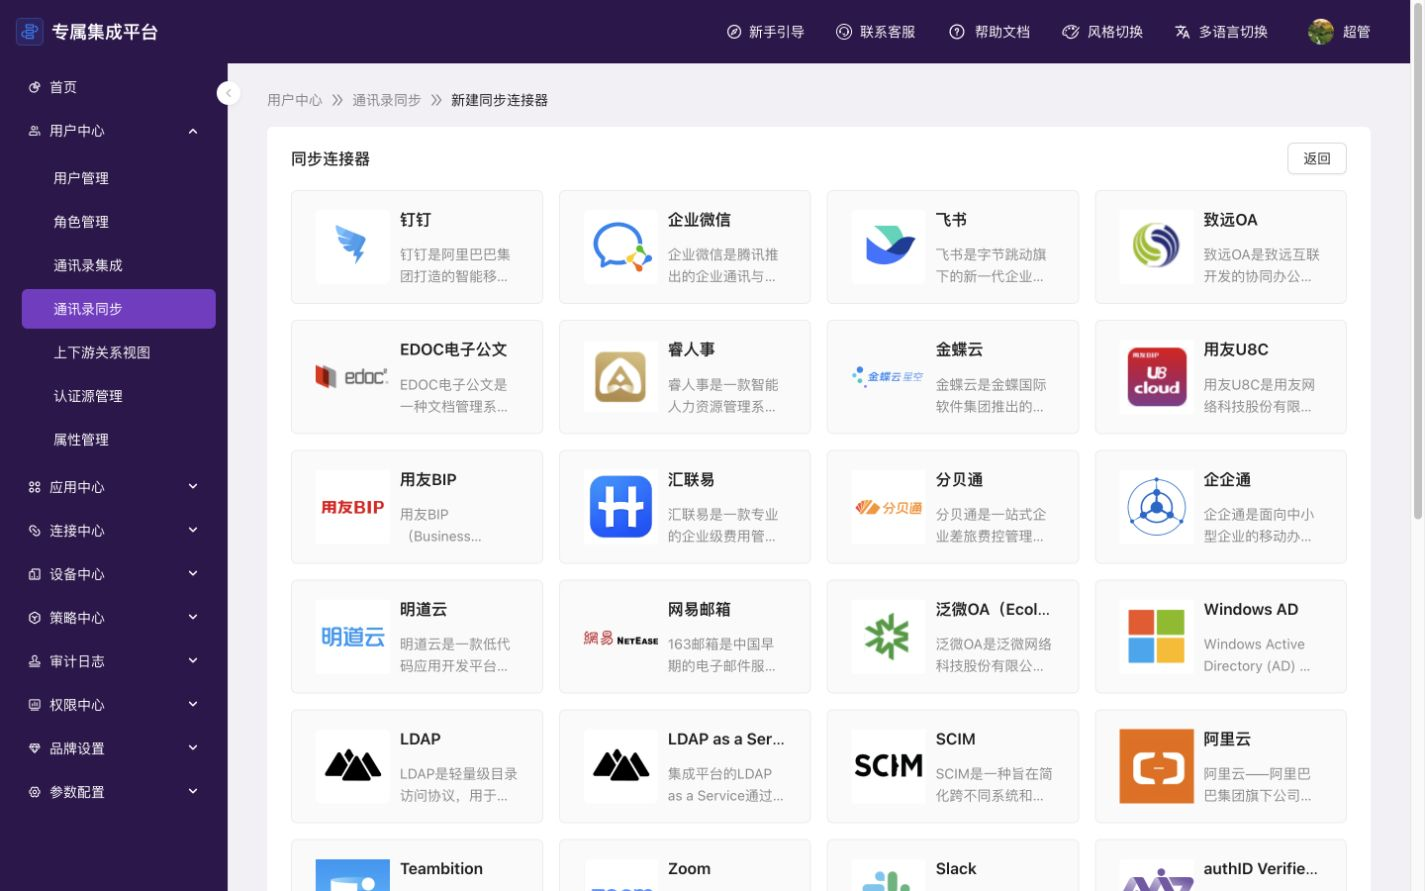
第三方系统的 API 权限、字段、限流和网络条件不由平台单方面保证。静态配置存在也不等于目标租户已经打通;上线前必须完成真实数据的端到端验收。通讯录同步是将专属集成平台中的组织架构和用户信息推送到下游应用系统(如钉钉、企业微信、AD/LDAP 等)的功能。数据流向为:专属集成平台 → 下游系统。平台作为用户数据的主数据源和统一管理中心,通过通讯录同步将用户数据自动分发到各个下游业务系统,确保多系统间身份数据的一致性。核心价值#
多系统数据一致:确保下游系统使用统一的、最新的用户信息
集中管控:从专属集成平台统一管理多个系统的身份数据
账号自动创建:新用户添加到平台后自动在下游系统创建对应账号
权限自动分配:基于组织架构和角色自动在下游系统分配权限
减少运维负担:无需在多个系统中重复维护相同的组织和用户信息
准备工作#
下游系统管理员权限:拥有目标下游系统的管理员权限,用于创建应用和配置 API 授权
网络要求:确保专属集成平台服务器可以访问下游系统的 API 接口
下游系统配置完成:已在下游系统准备好应用的认证信息(如 AppKey、AppSecret 等)
快速入门#
步骤 1:选择目标系统#
根据业务需求,确定需要将平台用户数据推送到哪些下游系统。参考上方支持的目标系统列表。步骤 2:创建同步任务#
在专属集成平台中,进入「用户中心 → 通讯录同步」,点击「添加连接器」按钮,选择对应的目标系统类型。步骤 3:配置并执行同步#
依次完成:目标连接配置 → 字段映射 → 同步规则设置 → 测试执行。具体配置请参考各目标系统的配置文档。重要:首次同步前,建议先在测试环境或小范围内验证配置正确性,避免大规模数据误同步。
数据流向#
专属集成平台(用户中心)                  下游系统
       │                                    │
       ├── 组织架构数据 ─────────────────→  钉钉通讯录
       ├── 用户数据     ─────────────────→  企业微信通讯录
       ├── 用户数据     ─────────────────→  AD/LDAP 目录
       └── 用户数据     ─────────────────→  其他业务系统
提示:如需将第三方身份源系统的数据拉取到平台,请阅读通讯录身份集成概述(数据方向相反:上游系统 → 平台)。
常见概念#
| 概念 | 说明 |
|---|
| 同步任务(连接器) | 在平台中创建的一条同步配置,定义了从平台到某个下游系统的数据推送规则 |
| 字段映射 | 将平台的用户/组织属性与下游系统字段建立对应关系,确保数据正确转换 |
| 同步范围 | 指定哪些用户/部门数据参与同步,支持全量和部分两种模式 |
| 同步方式 | 包括自动增量(仅同步变更)、自动全量(定期全量同步)和手动全量三种 |
| 删除阈值 | 安全保护机制:当待删除用户比例超过阈值时暂停删除,需管理员确认后才执行 |
| 强制创建 | 开启后,同步时若下游系统不存在对应记录,则强制创建;关闭则跳过 |
下一步#
先选择与数据方向匹配的标准连接器;只有标准连接器不能表达业务规则时再选择连接流。进入对应配置指南后,按“连接—映射—测试—同步—回读”顺序完成实施。